




Záver roka 2026 bude pre Anthropic veľmi rušný. V dňoch pred 9. októbrom spoločnosť takmer súčasne uviedla dvoch členov rodiny Claude 5.5, varianty Sonnet a Haiku. To je však teraz pre ňu tá menej dôležitá výzva, pretože sa práve pripravuje na IPO. Podľa správ by tento významný hráč v odvetví umelej inteligencie mohol vstúpiť na burzu v novembri.
Pod značkou Claude sú tak popri modeli Claude Opus 5.5, určenom na hĺbkové analytické uvažovanie a zložité rozhodovanie, už dostupné aj Claude Sonnet 5.5 na každodennú vývojársku a kancelársku prácu a Claude Haiku 5.5, ktorý širokému okruhu používateľov ponúka rýchlosť a nízke náklady. Nové modely prinášajú výrazný pokrok v efektivite aj programátorských schopnostiach a stávajú sa silnými súpermi modelov GPT-6.
Sonnet 5.5 sa oproti modelu Sonnet 5 zlepšil vo výkone, programovaní, znalostnej práci, dlhodobých úlohách agentov, interpretácii obrazového obsahu, spolupráci, rýchlosti aj efektivite. Haiku 5.5 sa najlepšie hodí na krátke a opakujúce sa úlohy, napríklad sumarizáciu, kompresiu, databázové dotazy a klasifikáciu. Okrem toho môže pod vedením modelov Claude Opus 5.5 a Claude Sonnet 5.5 fungovať ako agent na vykonávanie programátorských úloh.
Claude Haiku 5.5 je prvý model triedy Haiku s dostatočne silnými schopnosťami na jemné dolaďovanie. Používatelia si tak môžu podľa svojich potrieb nastaviť rovnováhu medzi čo najnižšími nákladmi a vyššou úrovňou schopností modelu.
Pri modeli Sonnet 5.5 už nie je novinkou možnosť pracovať na rôznych úrovniach, vďaka čomu sa vždy prispôsobí optimálnej úrovni uvažovania. Podľa viacerých testov už Sonnet 5.5 max dosahuje výkon porovnateľný s modelom Opus 5.5. V rýchlejších a efektívnejších nastaveniach zasa prekonáva Sonnet 5, pričom náklady môžu klesnúť až na desatinu.
Claude Sonnet 5.5 sa podaril natoľko, že v krajných prípadoch môže prekonať aj Opus 5.5, hoci jeho prevádzka stojí polovicu.
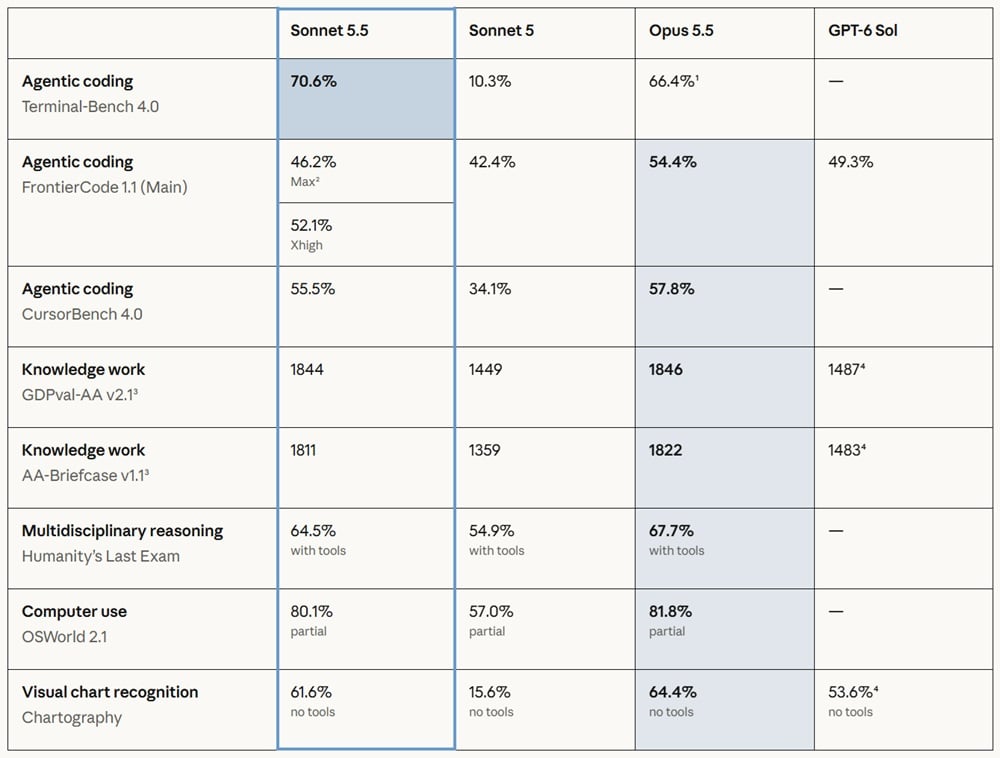
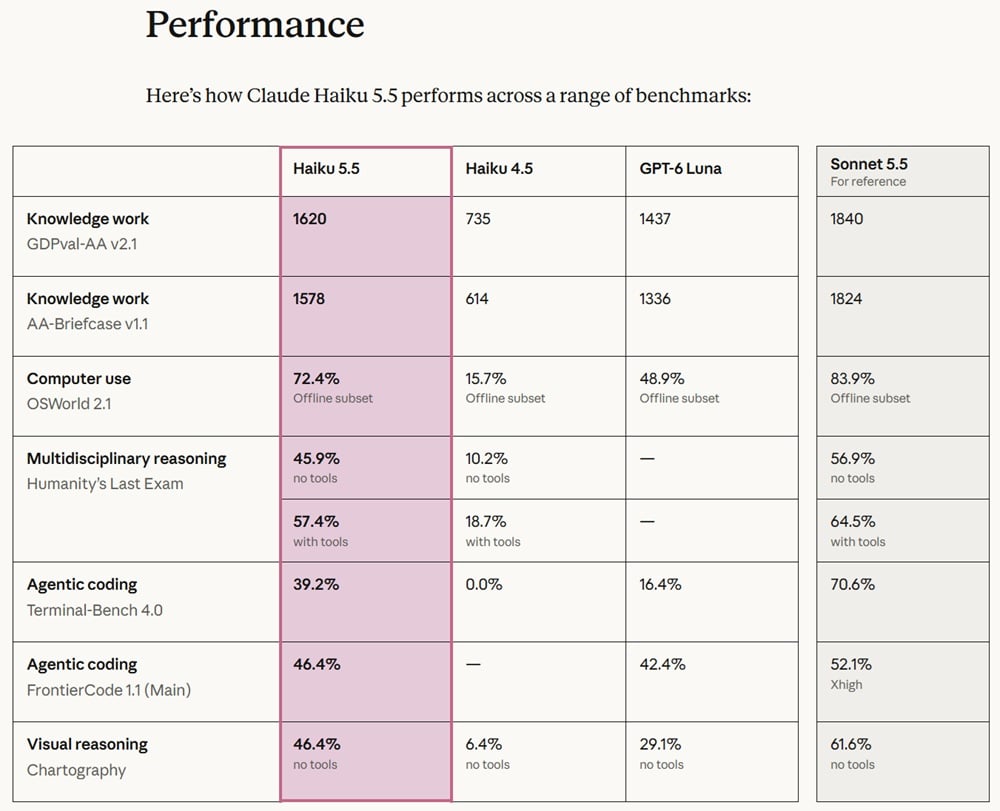
Napríklad v teste Terminal-Bench 4.0 dosiahol Sonnet 5.5 výsledok 70,6 %, zatiaľ čo väčší model skončil na 66,4 %. V GDPval-AA 2.1 už za modelom Opus zaostáva, ale iba tesne: získal 1.844 bodov oproti jeho 1.846 bodom. GPT-6 Sol tu dosahuje iba 1.487 bodov. V teste FrontierCode 1.1, ktorý hodnotí programátorské schopnosti agentov, dosahuje Sonnet 5.5 podľa nastavenia úspešnosť 46,2 až 52,1 %. Opus 5.5 zvláda 54,4 % a GPT-6 Sol sa môže pochváliť úspešnosťou 49,3 %.
Podľa meraní zverejnených spoločnosťou Anthropic dosahuje Claude Haiku 5.5 v teste GDPval-AA 2.1 zameranom na znalostnú prácu 1.620 bodov. Prekonáva tým aj model GPT-6 Sol od OpenAI, hoci jeho skutočným súperom je GPT-6 Luna, ktorý v tomto teste získal iba 1.437 bodov. V populárnom a veľmi náročnom teste Humanity’s Last Exam dokáže s použitím doplnkových nástrojov dosiahnuť výsledok 57,4 %. Prekonáva tak aj Sonnet 5.5 bez nástrojov (56,9 %), hoci ten môže byť až 20-krát drahší. Podobná situácia je aj v teste FrontierCode 1.1, kde sa s výsledkom 46,4 % už vyrovná modelu Sonnet 5.5 v úspornejšom nastavení a s prehľadom prekonáva GPT-6 Luna (42,4 %).
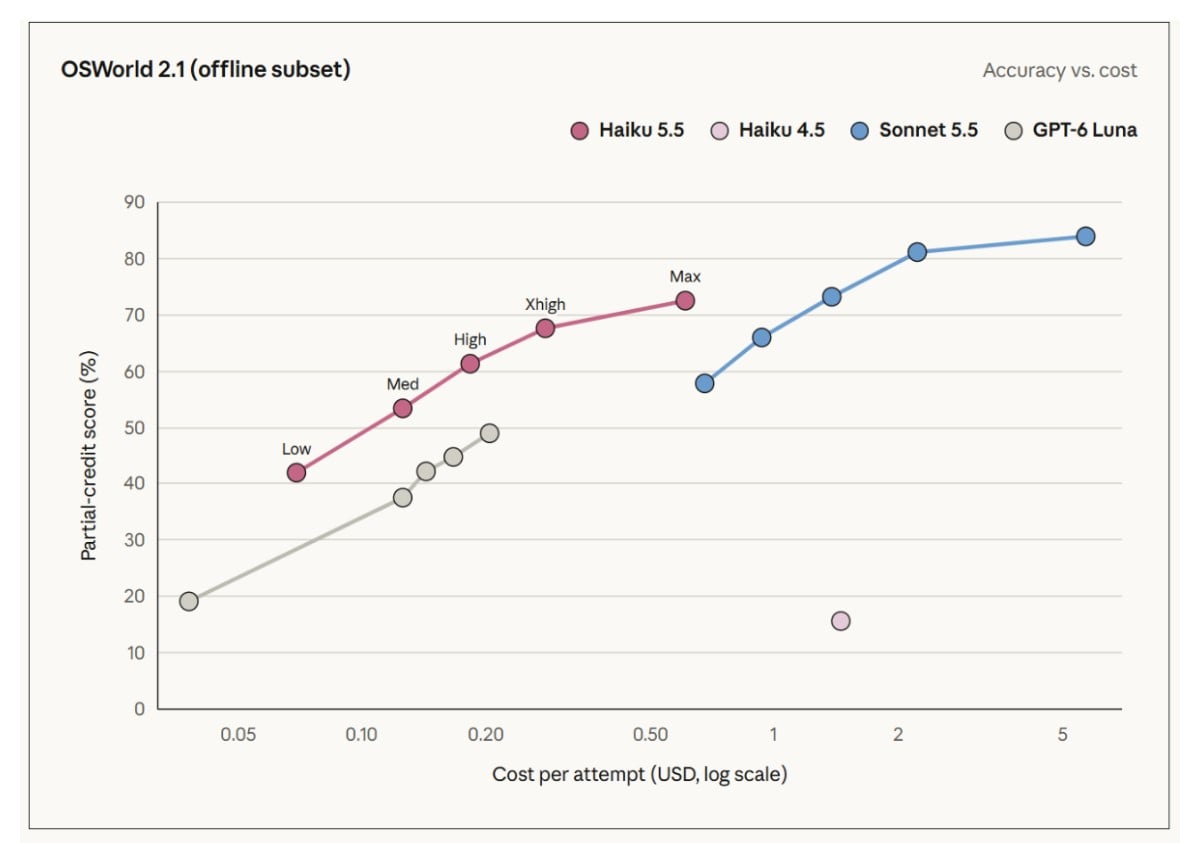
Anthropic zdôraznil, že s novými modelmi ponúka Claude 5.5 mimoriadne dobre škálovateľný systém, napríklad pri programovaní. Firmy tak získavajú balík, s ktorým môžu oveľa lepšie kontrolovať náklady a zároveň dosahovať vyšší výkon a presnejšie výsledky. Úlohy zadané modelu Claude Opus 5.5 môžu riešiť agenti využívajúci Sonnet 5.5 pod dohľadom najvýkonnejšieho modelu. Sonnet 5.5 zasa môže na menšie čiastkové úlohy vytvárať podagentov bežiacich na Haiku 5.5. CursorBench aj OSWorld namerali vynikajúce výsledky pri všetkých členoch série.
V oblasti kybernetickej bezpečnosti má Haiku 5.5 prísnejšie ochranné opatrenia než Haiku 4.5 a z hľadiska biologickej bezpečnosti už dosahuje rovnakú úroveň ako modely Sonnet a Opus. Na posilnení bezpečnosti spolupracoval Anthropic s poprednými odborníkmi v odvetví. Automatizované testovanie správania modelov v spoločnosti pokrýva viac než 1.800 scenárov a Sonnet 5.5 predstavuje oproti modelu Sonnet 5 výrazný posun takmer vo všetkých oblastiach.
Nové modely boli používateľom okamžite sprístupnené na všetkých platformách. Claude Haiku 5.5 má odlišné ceny pre prompty s menej než 100.000 tokenmi a pre väčšie úlohy. Kým úloha zostáva pod hranicou 100.000 tokenov, spracovanie 1 milióna tokenov v celej konverzácii môže stáť iba 0,1 dolára a vytvorenie rovnakého množstva obsahu 0,5 dolára. Pri dlhšom prompte sa však tieto náklady zvýšia päťnásobne, teda na 0,5 a 2,5 dolára.
Pri schopnejšom modeli Claude Sonnet 5.5 stojí spracovanie 1 milióna tokenov 2 doláre a vytvorenie rovnakého množstva tokenov 10 dolárov. Je teda podstatne drahší, no treba tiež vidieť, že výkonom sa už veľmi približuje modelu Claude Opus 5.5. Za ten sa pritom v oboch prípadoch platí dvojnásobok, takže z hľadiska efektivity je nový model jednoznačne lepšou voľbou. Pripravuje sa aj Claude Fable 5.5, na ktorom však Anthropic ešte pracuje a ktorý bude výrazne drahší než spomínané modely.