




DeepSeek, považovaný za veľkú čínsku nádej, po viacerých odkladoch uviedol svoju najnovšiu rodinu modelov DeepSeek-V4, ktorá bude dostupná vo viacerých veľkostiach. Ide o rozsiahlu aktualizáciu, ktorá zasahuje takmer do všetkých oblastí, no táto generačná obmena svetom neotrasie.
Séria DeepSeek-V4 využíva zdokonalenú techniku Mixture-of-Experts (MoE). Má si veľmi dobre poradiť s dlhým kontextom, výrazne zlepšiť schopnosť uvažovania a osvedčiť sa aj pri riešení úloh pomocou agentov.
Spoločnosť na úvod predstavila dva varianty: DeepSeek-V4-Pro a DeepSeek-V4-Flash. Zdôraznila, že už ide o „prelomový model umelej inteligencie s biliónom parametrov“. Vďaka novej generácii MoE má systém pracovať mimoriadne efektívne. Podľa oznámenia bude na dosiahnutie špičkového výkonu potrebovať v priemere iba 32 až 37 miliónov aktívnych parametrov, pričom ich môže byť aktívnych najviac 49 miliónov.
Podľa oficiálnych údajov môže mať DeepSeek-V4-Pro 1,6 bilióna parametrov, zatiaľ čo DeepSeek-V4-Flash má 284 miliárd parametrov. V4-Pro je určený na odborné úlohy a výskum, kým V4-Flash má rýchlo a efektívne odpovedať na všeobecné otázky. Spoločnosť novú generáciu trénovala odlišnými metódami než doteraz, a to na 33 biliónoch tokenov. Používa novú architektúru a množstvo optimalizácií na úrovni celého systému, ktoré majú znížiť nároky na výpočtový výkon a pamäť.
Model je navrhnutý ako natívne multimodálny. Vývojári ho od základu pripravovali na to, aby pri riešení úloh dokázal súčasne spracúvať text, obrázky, videá aj zvukové nahrávky. DeepSeek-V4 dokáže samostatne fungovať ako „agent“ a sľubuje mimoriadne dobré schopnosti pri programovaní. Všetky technologické spoločnosti intenzívne zdokonaľujú schopnosti svojich modelov pri písaní kódu, pretože práve toto využitie im v súčasnosti prináša najviac príjmov.
DeepSeek pri oznámení výrazne zdôraznil, že jeho otvorený model bude po novom podobne ako konkurencia ponúkať kontextové okno s kapacitou 1 milión tokenov. Google Gemini bol prvým významným modelom, pri ktorom vývojári dosiahli hranicu 1 milióna tokenov. Postupne sa z nej stáva odvetvový štandard, ktorý má odteraz spĺňať každý ďalší model DeepSeek. Vďaka tomu má podľa spoločnosti model pracovať s vynikajúcou presnosťou aj pri veľkom množstve informácií či dlhom kóde.
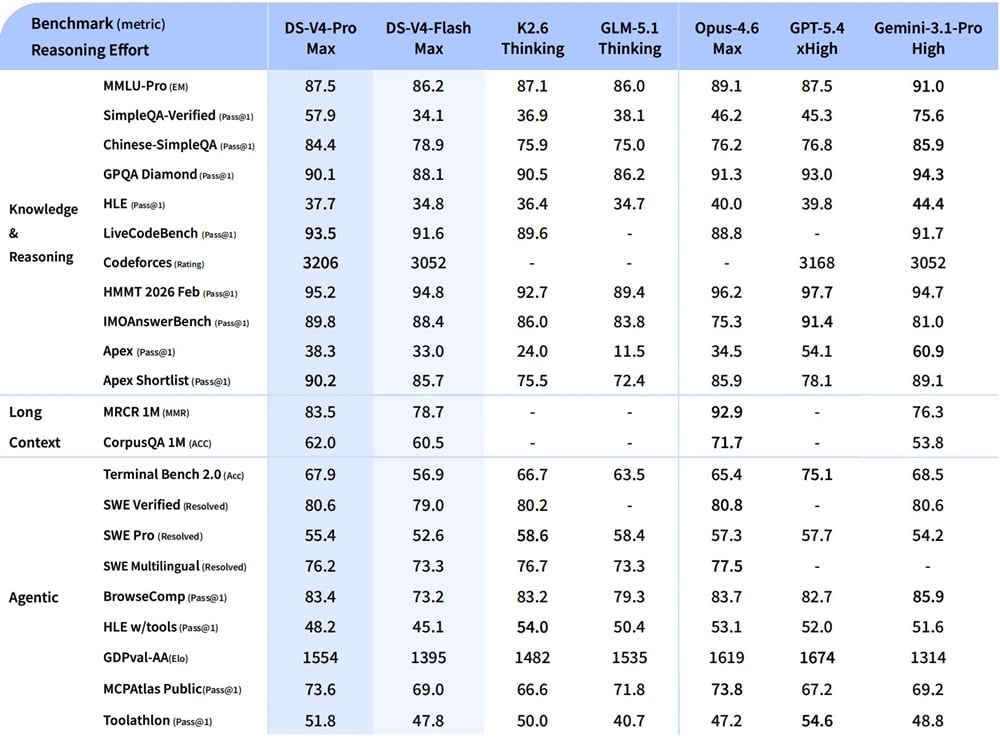
V populárnom teste Humanity's Last Exam sa novinke od DeepSeek príliš nedarí. S výsledkom iba 35,9 % výrazne zaostáva za modelmi Gemini 3.1, GPT-5.5 a Claude Opus 4.7. Všetci lídri už aj bez doplnkov dosahujú približne 40 %, väčšinou však túto hranicu prekračujú. V teste SWE-Bench Pro, ktorý hodnotí schopnosti agentov, dosahuje GPT-5.5 už 58,6 % a Claude Opus 4.7 sa môže pochváliť výsledkom 64,3 %. Nový DeepSeek-V4-Pro však zvládne iba 55,4 %. Spoločnosť vo vlastných testoch novinku rada porovnávala so staršími konkurenčnými modelmi, aby nový model vyzeral v lepšom svetle.
DeepSeek vo svojej správe tiež poznamenal, že nová rodina modelov V4 už nebola optimalizovaná pre GPU od Nvidie, hoci pobeží aj na hardvéri tejto spoločnosti. Americké sankcie prinútili čínsku firmu obrátiť sa na domáce hardvérové riešenia, a tak sa jej hlavným partnerom pri novom nástroji umelej inteligencie stal Huawei. DeepSeek-V4 je „optimalizovaný špeciálne pre čipy Huawei Ascend 950PR a Cambricon MLU“.
Z hľadiska nákladov sa nová séria podobne ako jej predchodcovia drží veľmi dobre. Hoci teda v testoch nepredvádza revolučný výkon, jej nákladová efektívnosť je nesporná. Pri DeepSeek-V4-Pro stojí vstup 1 milióna tokenov v najhoršom prípade 1,74 dolára, no k dispozícii je aj vyrovnávacia pamäť vstupov, ktorá dokáže túto sumu ešte znížiť. Rovnaké množstvo dát na výstupe stojí 3,48 dolára. Pri DeepSeek-V4-Flash stojí spracovanie 1 milióna tokenov iba 0,14 dolára a vygenerovanie 1 milióna tokenov vyjde na 0,28 dolára.